Авторегрессия (AR, autoregression) — классический метод прогнозирования временных рядов, который строит прогноз спроса как линейную комбинацию нескольких предыдущих значений продаж. Эта страница — детальное исследование по методу: формула, пример расчёта и почему рост порядка модели не всегда даёт лучший прогноз, с таблицей ошибок на реальных данных. Общую теорию, ARIMA, ограничения и код на Python разбираем в статье «Авторегрессия: формулы, примеры и ограничения» — если нужен более широкий обзор темы, начните с неё.
Результаты сравнения обобщены на графике ниже: по оси Х — товары, по оси Y — на сколько процентов Forecast NOW! оказывается лучше, чем алгоритм авторегрессии. Как можно видеть, почти всегда алгоритм Forecast NOW! прогнозирует точнее на 10–20 %. Подробнее об алгоритме и сравнении читайте ниже.
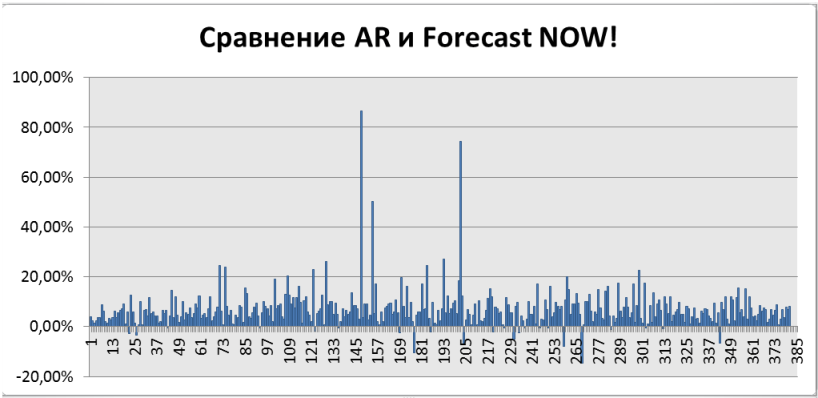
Рисунок 1. Насколько прогноз Forecast NOW! точнее авторегрессии: по оси X — товары, по оси Y — выигрыш в точности, %.
Описание модели авторегрессии
Ниже — короткий разбор, необходимый, чтобы понять условия сравнения. Полная теория с выводом формулы AR(p), проверкой стационарности, ACF и PACF, ARMA и ARIMA и построением модели на Python — в статье «Авторегрессия: формулы, примеры и ограничения».
Прогнозирование с использованием модели авторегрессии опирается на предыдущие значения продаж: слово «авторегрессия» означает зависимость последующего значения от предыдущих. Зависимость предполагается линейной — прогноз представляет собой сумму продаж за предыдущие периоды с постоянными коэффициентами. Сколько периодов из прошлого при этом учитывается, называется порядком модели авторегрессии (p). Например, если для прогноза используются продажи за предыдущие три дня, порядок модели p = 3, что кратко записывается как AR(3).
Прогноз(t+1) = c + φ₁ × Продажи(t) + φ₂ × Продажи(t−1) + φ₃ × Продажи(t−2)
Здесь c — константа модели, которая всегда прибавляется к прогнозу, а φ₁, φ₂, φ₃ — коэффициенты, на которые умножаются продажи за прошлые периоды. В спросе присутствует и случайная составляющая (белый шум) — она моделирует ту часть колебаний продаж, которую не объясняют предыдущие значения. Для реального применения все эти параметры (порядок и коэффициенты) подбираются программой: в модель авторегрессии можно добавить и сезонность: например, для недельной сезонности в модель включаются продажи ровно 7 дней назад.
Сам по себе белый шум не имеет никакой структуры — это те колебания спроса, которые модель объяснить не может:
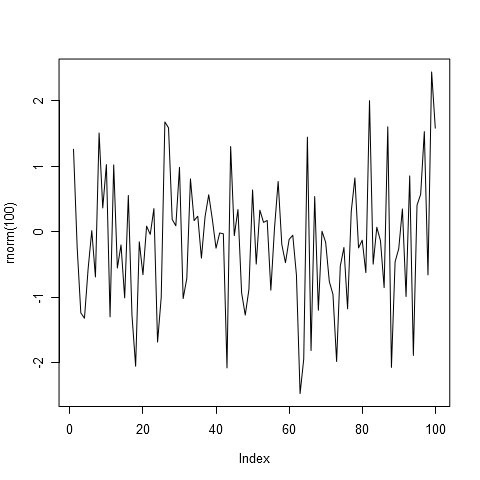
Рисунок 2. Белый шум в авторегрессии — случайная составляющая спроса.
Пример подстановки в формулу
Возьмём модель AR(3) с коэффициентами c = 5, φ₁ = 0,5, φ₂ = 0,3, φ₃ = 0,1 — то есть больший вес отдаётся более свежим продажам. Продажи за последние три дня составили 40, 35 и 30 единиц соответственно. Прогноз на следующий день:
Прогноз = 5 + 0,5 × 40 + 0,3 × 35 + 0,1 × 30 = 5 + 20 + 10,5 + 3 = 38,5 единицы
Если бы продажи за три дня были более стабильными (например, 38, 37, 36), прогноз оказался бы ближе к простому среднему. Авторегрессия начинает заметно отличаться от скользящей средней именно тогда, когда веса коэффициентов сильно неравномерны или в данных есть выраженная динамика.
Как порядок модели влияет на качество прогноза
Логично предположить: чем точнее модель «подгоняется» к историческим данным, тем лучше должен быть прогноз. На практике это не так. Исходные данные о продажах содержат шум, провалы и выбросы — и при большом порядке модель не обобщает тенденцию, а буквально запоминает исторические данные со всеми их случайными искажениями. В результате модель с высоким порядком прекрасно повторяет прошлое, но плохо прогнозирует будущее — это классическое переобучение (overfitting).
Наглядно видно, как модель всё плотнее облепляет исторические данные по мере роста порядка:
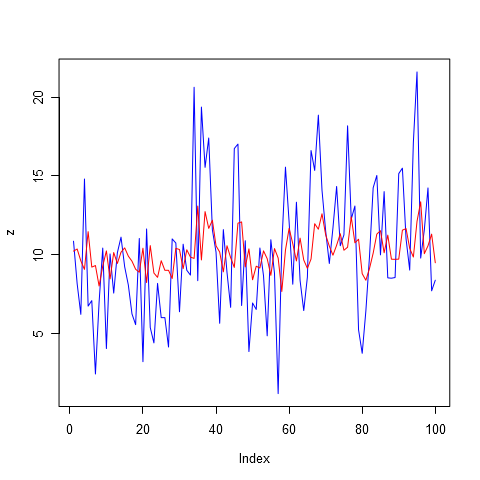
Рисунок 3. Авторегрессия, порядок модели p = 1: модель слишком груба и не улавливает закономерности.
При p = 8 модель уже улавливает недельный цикл: линия повторяет регулярные подъёмы и спады, а не просто сглаживает ряд:
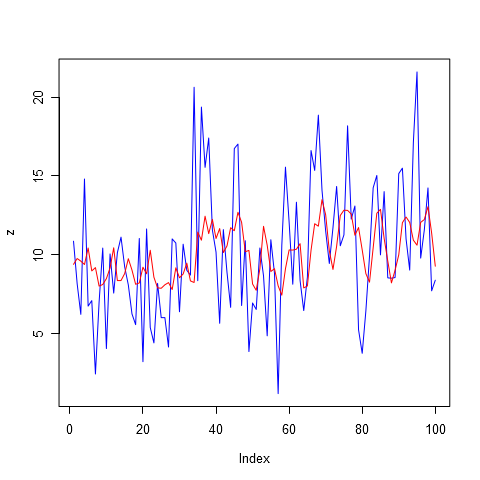
Рисунок 4. Авторегрессия, порядок модели p = 8: модель улавливает недельную сезонность.
А если поднять порядок до 28, модель почти сливается с историей. Выглядит как идеальное попадание, но это уже переобучение:
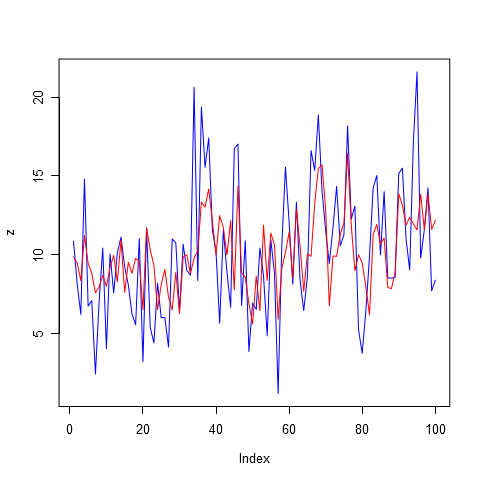
Рисунок 5. Авторегрессия, порядок модели p = 28: модель повторяет историю почти в точности — это и есть переобучение.
Разница проявляется на прогнозе вперёд: то, что на истории выглядело точнее, на будущих периодах ведёт себя хуже. Сначала модель порядка 8:

Рисунок 6. Прогноз на 56 дней вперёд, авторегрессия порядка 8 — AR(8).
Теперь то же самое, но порядком 32. Модель сложнее, а прогноз вперёд от этого не выиграл:

Рисунок 7. Прогноз на 56 дней вперёд, авторегрессия порядка 32 — AR(32): избыточный порядок не улучшил прогноз.
На реальных данных о продажах это выглядит так: при увеличении порядка модели с 8 до 32 ошибка прогноза (RMSE) не падает, а растёт:
Модель AR(8) в этом примере учла недельную сезонность и дала наименьшую ошибку; дальнейшее увеличение порядка (14, затем 32) только ухудшало прогноз — модель начинала подстраиваться под случайный шум сверх реальной закономерности.
Полные результаты замера по всем проверенным порядкам модели:
Таблица 1. Ошибка прогноза авторегрессии при разных порядках модели. Минимум приходится на p = 7–8; дальше рост порядка только ухудшает результат.
Простыми словами: модель авторегрессии с низким порядком слишком грубая и не видит закономерностей вроде недельной сезонности; с чрезмерно высоким — учится «наизусть» повторять историю продаж, включая случайные всплески, и теряет способность обобщать.
На практике для выбора порядка вводят штраф за сложность модели: чем больше параметров, тем выше штраф, и модель должна «окупать» дополнительную сложность заметным приростом точности. Вопрос, какой штраф использовать и где проходит граница разумной сложности, — предмет отдельных исследований, единого правильного ответа здесь нет.
Авторегрессия хорошо работает только при гладком регулярном спросе — такой характер спроса типичен примерно для 6 % ассортимента типового продуктового супермаркета. Почему так, что это означает для остального ассортимента и как AR соотносится с ARIMA, вероятностными алгоритмами и нейросетями — разобрано в статье «Авторегрессия: формулы, примеры и ограничения». Здесь — только методология и результаты сравнения с Forecast NOW! по RMSE.
О причинах, по которым мы в принципе не рекомендуем сравнивать алгоритмы по ошибке RMSE (в том числе результаты ниже), — в статье «Почему мы не считаем MAPE, RMSE и другие математические ошибки при прогнозировании спроса». Рекомендуемый способ сравнения — имитационное моделирование денежных потерь, а не абстрактная ошибка прогноза.
Сравнение прогнозов авторегрессии с Forecast NOW!
Важное замечание: сравнение ниже построено на ошибке прогнозирования RMSE, и это не тот способ, которым мы рекомендуем выбирать алгоритм. Математическая ошибка не показывает, во сколько обойдётся промах в деньгах: она не различает дефицит и излишек и не учитывает страховой запас. Мы приводим RMSE только потому, что это привычная метрика, по которой методы сопоставимы между собой. Почему она не годится для решений о запасах — в статье «Почему мы не считаем MAPE, RMSE и другие математические ошибки». Рекомендуемый способ сравнения — имитационное моделирование денежных потерь на реальном ассортименте.
Для сравнения с алгоритмом Forecast NOW! были построены прогнозы методом авторегрессии с разными значениями порядка модели; для каждого товара выбиралась лучшая по ошибке на исторических данных модель с учётом штрафа за сложность. Результат: почти во всех случаях алгоритм Forecast NOW! оказывается точнее в среднем на 10–20 % по метрике RMSE — при том, что сама метрика RMSE, как объяснено в статье выше, недостаточна для окончательных бизнес-решений и используется здесь только для сопоставимости с классическим методом.
Результат по каждому товару: по оси X — товары, по оси Y — насколько прогноз Forecast NOW! оказался точнее авторегрессии:
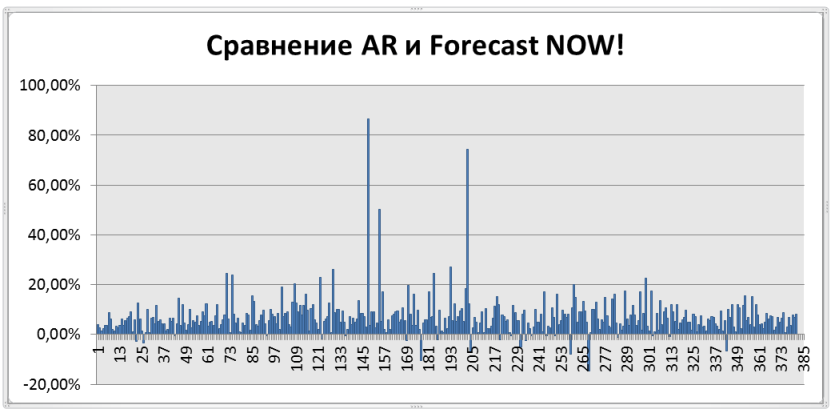
Рисунок 8. Сравнение точности прогнозирования авторегрессии и алгоритма Forecast NOW!
Числовые значения ошибок по каждому товару и разница между методами в процентах:
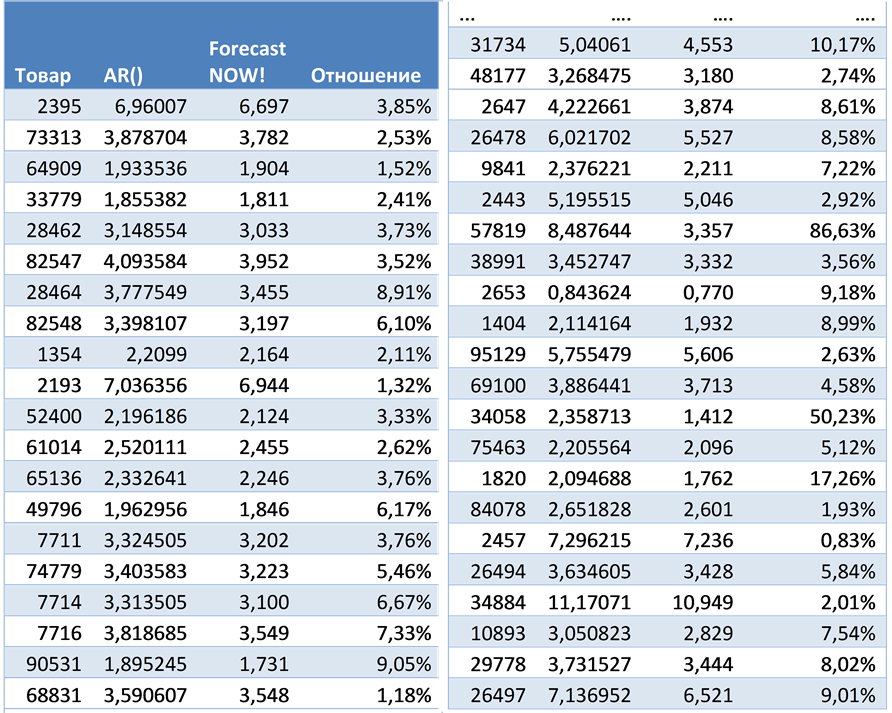
Рисунок 9. Ошибки прогнозирования авторегрессии и алгоритма Forecast NOW!, а также процентное соотношение качества прогнозов.
Частые вопросы
Насколько Forecast NOW! точнее авторегрессии?
Почти во всех случаях точнее оказывается Forecast NOW! — в среднем на 10–20 %. Разница по отдельным позициям неодинаковая: где-то это единицы процентов, где-то — десятки. Числовые значения по каждому товару приведены в таблице выше.
Почему сравнение сделано по RMSE, если вы сами её не рекомендуете?
Потому что RMSE — привычная метрика, по которой методы сопоставимы между собой, и по ней авторегрессию сравнивают в учебниках и статьях. Для решений о запасах она не годится: не различает дефицит и излишек и не переводит ошибку в деньги. Рекомендуемый способ — имитационное моделирование денежных потерь.
Как выбирался порядок модели для сравнения?
Для каждого товара перебирались модели разного порядка, и бралась лучшая по ошибке на исторических данных с учётом штрафа за сложность. Это заведомо выгодное для авторегрессии условие: в реальной эксплуатации оптимальный порядок заранее неизвестен.
Почему авторегрессия проигрывает на реальном ассортименте?
Она подбирает коэффициенты по прошлым продажам и предполагает, что структура ряда сохранится. На рваном спросе с промо, дефицитами и разовыми крупными отгрузками это предположение нарушается, а модель к тому же склонна переобучаться на шуме при росте порядка.
Где авторегрессия всё-таки уместна?
На товарах с гладким регулярным спросом без резких провалов и всплесков — это примерно 6 % ассортимента типового продуктового супермаркета. Там разрыв с более поздними алгоритмами минимален, и AR остаётся понятным и дешёвым в реализации вариантом.
Чем этот материал отличается от статьи про саму авторегрессию?
Здесь только методология и результаты сравнения с Forecast NOW!. Теория — вывод формулы AR(p), проверка стационарности, ACF и PACF, ARMA и ARIMA, построение модели на Python — разобрана в статье «Авторегрессия: формулы, примеры и ограничения».
Обзор других методов
Сравнения с Forecast NOW! по остальным методам — в том же цикле. В скобках — поколение алгоритма: чем выше номер, тем позже метод появился и тем больше факторов он учитывает.
- Авторегрессия: формулы, примеры и ограничения — полный разбор теории, ARIMA и применения на Python
- Простая скользящая средняя (SMA) — 1–2-е поколение
- Экспоненциальное сглаживание (ES) — 1–2-е поколение
- Метод Хольта — Винтерса — 1–2-е поколение
- Вероятностное прогнозирование — 4-е поколение